Machine learning · Metodologia · 2026
Riammissione a 30 giorni nei pazienti diabetici
Una pipeline di ML clinico end-to-end e un esperimento per capire se il protocollo di validazione conta quanto il modello. Non è così, e il risultato negativo è la cosa più utile che il progetto ha prodotto.
- AUC-PR sul test (prevalenza 0,114, lift 2,02×)
- 0,230
- riammissioni intercettate nel 10% a rischio più alto
- 24,3%
- l'unico effetto di protocollo risolto
- −8,2%
Il problema
Prevedere quali ricoveri di pazienti diabetici finiranno con una riammissione entro 30 giorni, per decidere chi inserire in un programma di transitional care con posti limitati. Il dataset è Diabetes 130-US Hospitals (UCI #296, CC BY 4.0): 101.766 ricoveri, 71.518 pazienti, fino a 40 ricoveri per paziente, circa l’11% di positivi.
L’ho scelto al posto di altri due dataset medici perché è pieno di problemi veri: pazienti ripetuti che obbligano a uno split per gruppo, valori mancanti non casuali, categoriche ICD-9 con oltre 700 livelli e un difetto nella definizione del target che bisogna scovare da sé.
Cosa ho costruito
- Due problemi nei dati, trovati e corretti. 2.752 ricoveri finiscono con un decesso o il trasferimento in hospice: quei pazienti non possono essere riammessi. Tenerli insegna al modello a riconoscere la mortalità e la fa passare per capacità predittiva. In due colonne di laboratorio, poi, la stringa
'None'significa “esame non richiesto”: è una decisione clinica, quindi un segnale, ma pandas la trasforma inNaNdi default. Il vero mancante è solo'?'. - Split per paziente (
StratifiedGroupKFold, 64/16/20), con un controlloassert_disjointche solleva un errore se un paziente finisce in due partizioni. - Tutto ciò che si fitta vive nella Pipeline. Niente
dropna(): i mancanti hanno una categoria esplicita e un flag*_recorded. - Metriche scelte in base alla decisione da prendere. AUC-PR invece dell’accuracy, soglia scelta minimizzando il costo atteso (rapporto assunto 10:1, con un’analisi di sensibilità da 1:1 a 50:1) e probabilità calibrate, perché il reparto deve sapere quanti pazienti arruolare.
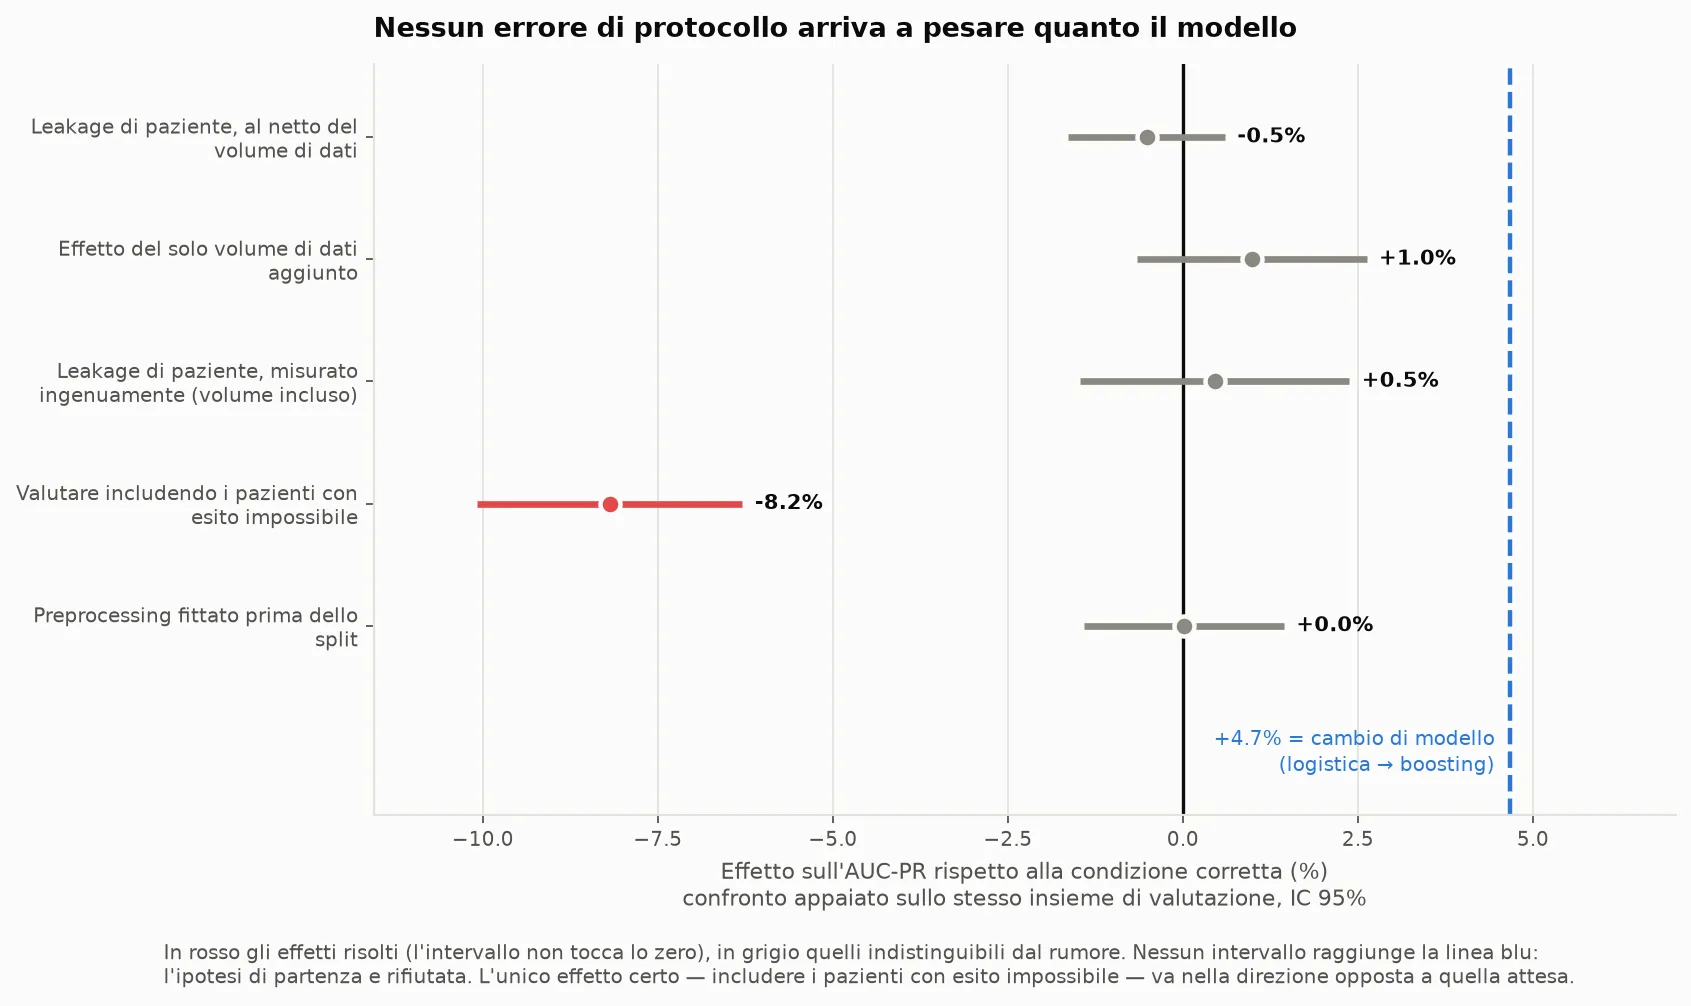
- L’esperimento sul protocollo. Confrontare due protocolli direttamente era il disegno sbagliato: producono test set diversi, e la variabilità tra campioni (circa 5 punti di deviazione standard) copre un effetto del 2%. Il disegno finale è appaiato e, per il leakage di paziente, ha un braccio di controllo sul volume di dati.
- Servizio FastAPI, una suite di test (dati, leakage, valutazione, contratto del modello, API) e un Makefile che codifica le fasi come un piccolo DAG.
Risultati
Modello finale: HistGradientBoosting, valutato una sola volta sul test (19.867 ricoveri, 13.951 pazienti mai visti in training).
| Metrica | Valore |
|---|---|
| AUC-PR | 0,230 (IC 95% 0,217–0,245); prevalenza 0,114, quindi lift 2,02× |
| AUC-ROC | 0,671 (IC 95% 0,659–0,683); la letteratura su questo dataset riporta 0,65–0,70 |
| Brier | 0,096 |
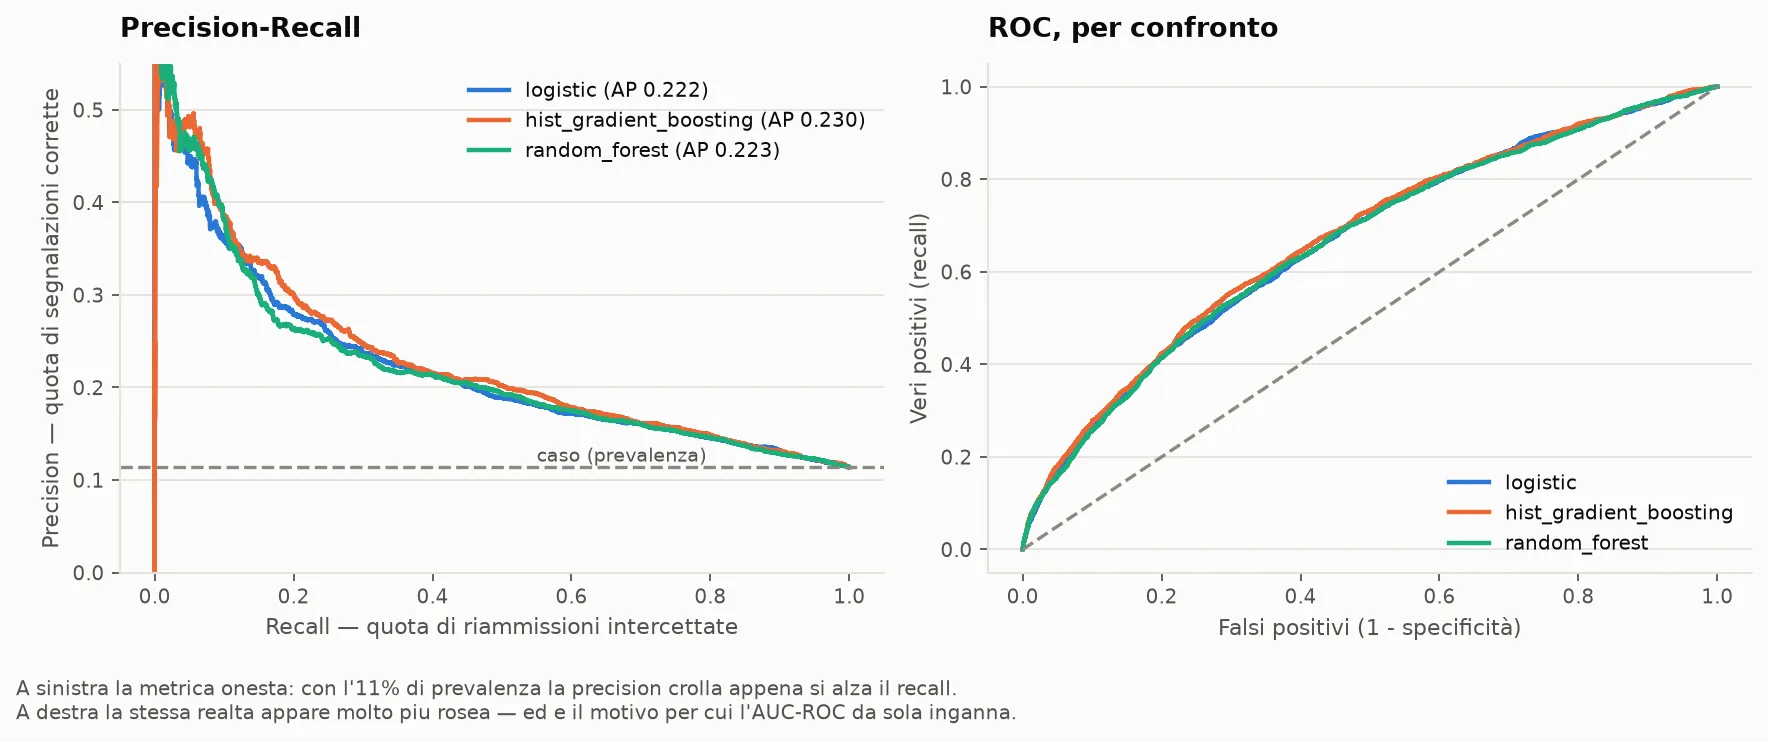
Seguendo il 10% dei pazienti a rischio più alto si intercetta il 24,3% delle riammissioni, contro il 10% atteso scegliendo a caso. Quattro riammissioni su cinque però restano fuori. Le famiglie di modelli si equivalgono quasi: in cross-validation circa 10 millesimi di AUC-PR separano la regressione logistica dal boosting.
L’ipotesi è stata rifiutata. Leakage di paziente (al netto del volume di dati): −0,5% [−1,6; +0,6]. Preprocessing fittato prima dello split: +0,0% [−1,4; +1,4]. Valutare includendo i pazienti con esito impossibile: −8,2% [−10,1; −6,3]. È l’unico effetto risolto, e va nella direzione opposta a quella che mi aspettavo. Nessuno si avvicina al +4,7% che si ottiene passando dalla logistica al boosting.
Limiti
Il segnale è debole per natura: nessuna variabile separa le classi (|d di Cohen| < 0,4). Il modello riconosce soprattutto chi usa molto il sistema sanitario, non chi è più malato. La coorte è al 75% caucasica, quindi sui gruppi piccoli gli intervalli sono troppo larghi per dire qualcosa sull’equità. I dati sono statunitensi, 1999–2008, in codifica ICD-9. È uno strumento di priorità, non un dispositivo medico.